Какую модель GPT выбрать для AI-агента: GPT-4.1, GPT-4.1 Mini, o4-mini и GPT-5.6 Luna, Terra, Sol
Чем отличаются шесть моделей GPT в блоке AI-агент LEADTEX: рассуждение, контекст, цена, свежесть знаний. Как выбрать модель под задачу и проверить выбор тестом на своём сценарии.
В блоке AI-агент LEADTEX можно выбрать одну из шести моделей OpenAI: GPT-5.6 Luna, o4-mini, GPT-4.1 Mini, GPT-4.1, GPT-5.6 Terra и GPT-5.6 Sol. В большинстве сценариев не нужна самая дорогая модель. Для FAQ и коротких диалогов начните с Luna; для строгой инструкции, переменных, тегов и веток — с GPT-4.1 Mini; для задач с рассуждением сравните Terra и Sol на одинаковом тесте. Ниже — чем модели различаются по данным OpenAI, какие критерии важны для бота и как проверить выбор на своём сценарии.
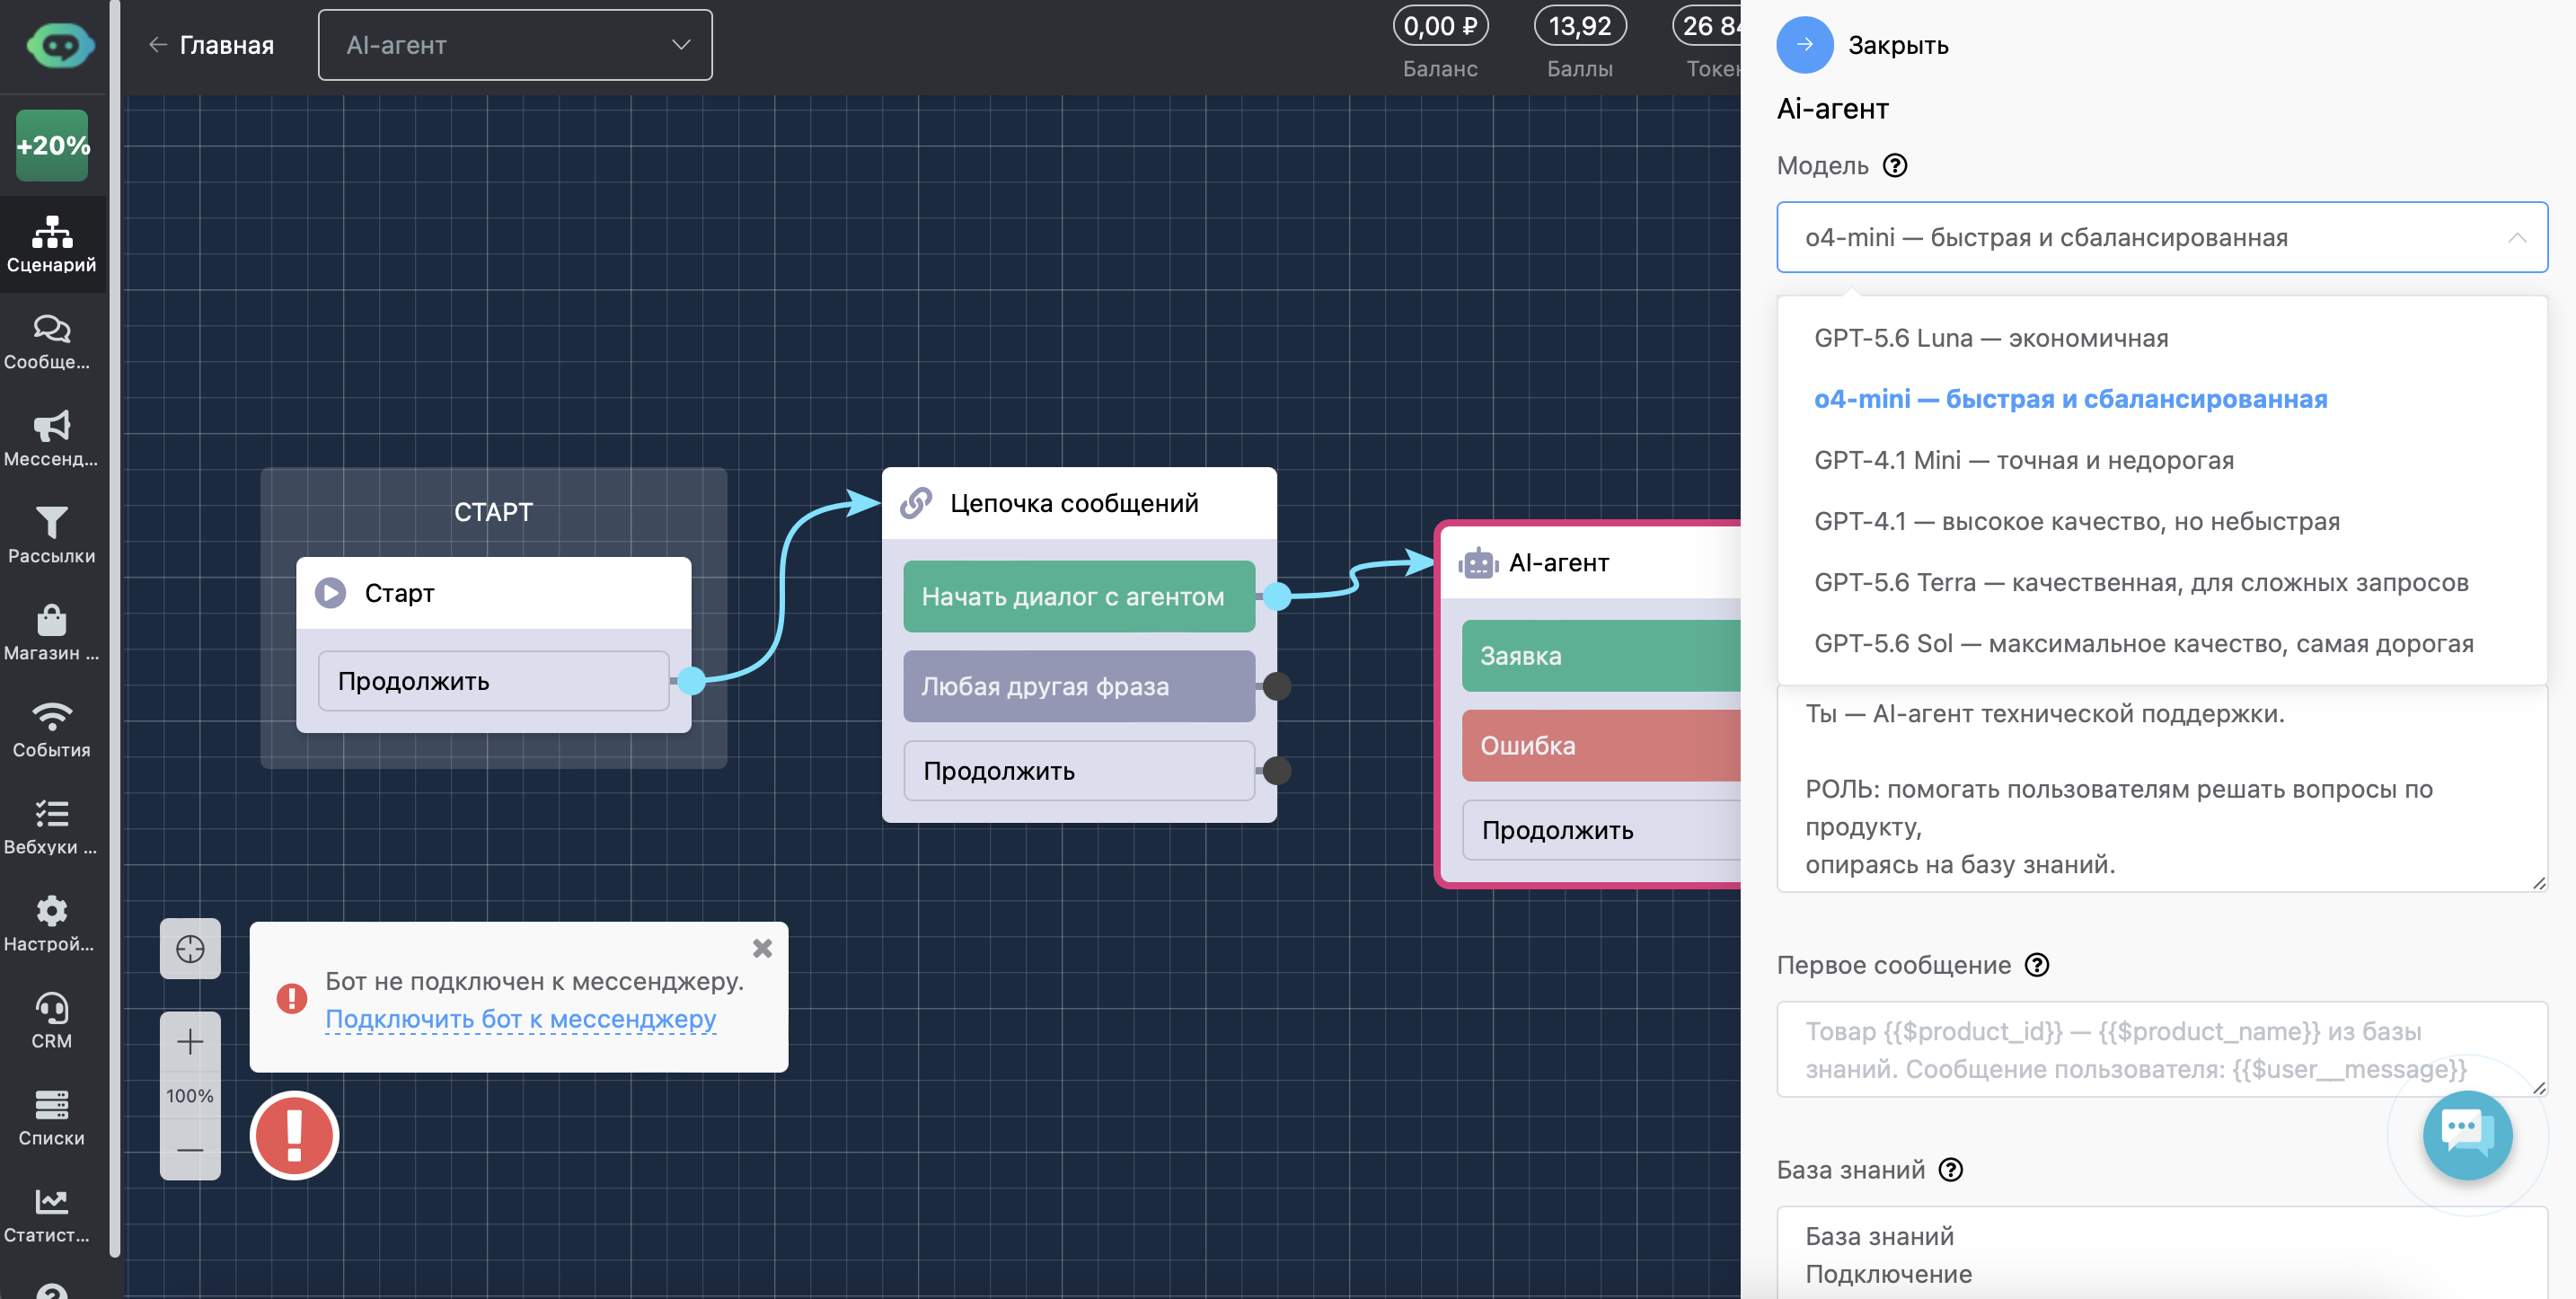
Выбор модели находится в поле «Модель» в настройках блока AI-агент.
Три семейства, а не шесть разных моделей
Шесть вариантов в списке принадлежат трём линейкам, и главное различие проходит именно между ними.
GPT-4.1 и GPT-4.1 Mini. Модели без «размышления»: OpenAI называет GPT-4.1 самой умной моделью без рассуждения. Они сразу выдают ответ, поэтому работают быстро. Сильная сторона по описанию OpenAI: следование инструкции и вызов инструментов. Mini — уменьшенная версия: быстрее и заметно дешевле.
o4-mini. Модель с рассуждением: перед ответом она тратит дополнительные токены на «размышление». OpenAI описывает её как быструю и недорогую модель для рассуждений, сильную в программировании.
GPT-5.6 Luna, Terra и Sol. Новое поколение. Три ступени одной линейки: Luna для дешёвых массовых задач, Terra как золотая середина, Sol как флагман для сложной профессиональной работы.
Цена растёт с классом модели. По прайсу OpenAI Sol дороже Luna примерно в 20 раз на входе и в 17 раз на выходе, GPT-4.1 дороже Mini в 5 раз. Эти цены показывают относительную стоимость моделей у провайдера, но не равны списанию токенов LEADTEX: платформа списывает собственные токены. Фактический расход конкретного сценария проверяйте во вкладке «Расход».
Рассуждение не всегда нужно. Модели без рассуждения отвечают быстрее, и для FAQ или сбора контактов этого достаточно. Рассуждающие модели нужны там, где ответ надо вывести, а не найти в базе: расчёты, сравнение условий, нестандартные вопросы.
Свежесть знаний важна, если агент отвечает не только по базе. У GPT-4.1 и o4-mini знания заканчиваются в июне 2024 года, у GPT-5.6 в феврале 2026. При работе по закрытой базе дата среза знаний менее важна, но модели всё равно могут различаться по соблюдению инструкции, обработке длинного контекста и стабильности маршрутизации. Если клиенты спрашивают про свежие события и продукты, у более новых моделей будет меньше пробелов.
Креативность недоступна у GPT-5.6. Для серии GPT-5.6 в LEADTEX настройка «Вариативность (креативность)» не работает. Если агент пишет персональные тексты и вам нужно управлять степенью свободы ответов, выбирайте среди GPT-4.1, GPT-4.1 Mini и o4-mini.
Рекомендации для старта работы с AI-агентом
Модель
Для чего
GPT-5.6 Luna
Простые вопросы и большое количество коротких диалогов
o4-mini
Задачи средней сложности
GPT-4.1 Mini
Диалоги, где важно точно следовать инструкции, работать с базой знаний, переменными, тегами и ветками
GPT-4.1
Сложные инструкции и большая база знаний
GPT-5.6 Terra
Сложные запросы, которые требуют рассуждения
GPT-5.6 Sol
Самые сложные задачи, когда качество важнее скорости и стоимости
Как выбрать за три вопроса
Универсального «лучшего» варианта нет: критерии зависят от того, что делает агент.
Агент отвечает на типовые вопросы или ведёт сложный разговор? Если вопросы простые и диалогов много, начните с GPT-5.6 Luna, а при большой базе знаний сравните её с GPT-4.1 Mini. Для задач средней сложности есть o4-mini.
Агент должен записывать данные, ставить теги и выбирать ветки? Начните с GPT-4.1 Mini. Если инструкция длинная, а база большая, переходите на GPT-4.1.
Клиенты задают запросы, где нужно рассуждение? Смотрите на GPT-5.6 Terra, а для самых сложных случаев на GPT-5.6 Sol. Начните с Terra и переходите на Sol только после одинакового теста на своём сценарии. Общего рейтинга недостаточно: для бота важны соблюдение запретов, корректная запись переменных и выбор ветки.
Правило одно: берите самую простую модель, которая подходит по описанию, и повышайте класс, только если тест выявил конкретную проблему.
Протокол теста: как проверить модель на своём сценарии
Описания общие, а ваша база знаний, инструкция и клиенты уникальны. Соберите один маршрут и прогоните его на трёх моделях по одинаковому набору диалогов: для надёжного сравнения нужно 10–20 одинаковых диалогов на модель, пять вопросов ниже — минимальный набор для быстрой проверки. Для начала возьмите пару GPT-4.1 Mini и GPT-5.6 Luna, третьей моделью добавьте GPT-5.6 Terra.
Пять вопросов, которые покрывают основные риски:
#
Что проверяет
Пример реплики клиента
1
Ответ по базе знаний
Вопрос, ответ на который есть в тексте базы
2
Соблюдение запрета
Просьба назвать то, что инструкция запрещает, например скидку или срок
3
Извлечение переменных из «пересыщенной» реплики
«Я Маша, из Казани, бюджет тысяч 30»
4
Условие тега
Реплика, после которой должен добавиться конкретный тег
5
Выбор ветки при неоднозначном финале
Клиент сомневается и не говорит ни «да», ни «нет»
Оценивайте каждый ответ по шкале: 0 (ошибка), 1 (частично), 2 (верно). Для сравнения фиксируйте: процент корректных ответов, соблюдение запретов, правильность переменных, тегов и веток, медианное время ответа, расход токенов LEADTEX на тест, а также дату теста и версию сценария. Расход видно на вкладке «Расход» раздела «Токены»: выберите период «Сегодня» и детализацию по часам, а каждую модель тестируйте в отдельный промежуток времени. Сценарий и вопросы должны оставаться одинаковыми, иначе на результат повлияет не только модель.
Шаблон таблицы результатов:
Модель
% корректных ответов
Запреты соблюдены
Переменные, теги, ветки верны
Медианное время ответа
Токены LEADTEX на тест
Замечания
GPT-4.1 Mini
GPT-5.6 Luna
GPT-5.6 Terra
Укажите под таблицей дату теста и версию сценария: через несколько месяцев модели и их настройки в блоке могут измениться.
Если дешёвая модель набрала столько же баллов, как дорогая, оставляйте дешёвую. Если модель ошибается на вопросах 3–5, сначала повторите тест с уточнёнными формулировками условий. Если ошибка сохраняется только на одной модели, причина, вероятно, в выборе модели; если на всех — в инструкции или логике сценария.
Как менять модель в работающем боте
Смена модели влияет на весь диалог: точность, скорость и стоимость. После переключения повторите тест на тех же пяти вопросах и прогоните финалы с ветками. Если бот уже работает с клиентами, сначала проверьте новую модель на тестовой копии сценария.
Частые вопросы
Какую модель выбрать, если не хочется разбираться?
Для сценариев с переменными, тегами и ветками начните с GPT-4.1 Mini. Для простого FAQ с большим потоком диалогов подойдёт GPT-5.6 Luna.
Чем GPT-5.6 Luna, Terra и Sol отличаются друг от друга?
Это три ступени одной линейки. Luna рассчитана на дешёвые массовые задачи, Terra балансирует цену и качество, Sol предназначена для сложной профессиональной работы.
Что значит «модель с рассуждением»?
Перед ответом такая модель тратит дополнительные токены на «размышление». Она справляется с задачами, где ответ нужно вывести, но отвечает медленнее и стоит дороже.
Почему для веток советуют Mini, а не самую мощную модель?
GPT-4.1 Mini хорошо следует инструкции и работает с переменными, тегами и ветками, а GPT-5.6 Sol нужна там, где качество важнее скорости и стоимости. Для точного исполнения заданных условий запас мощности обычно не нужен, тест покажет это на вашем примере.
Можно ли настроить креативность ответов у моделей GPT-5.6?
Нет, для серии GPT-5.6 настройка «Вариативность (креативность)» недоступна. Если она нужна, выберите GPT-4.1, GPT-4.1 Mini или o4-mini.
Где увидеть, сколько токенов тратит агент?
В разделе «Токены» на вкладке «Расход»: там графики по периодам и с детализацией по часам, дням, неделям и месяцам. Чтобы сравнить модели, запускайте их в разные промежутки времени.